假设我们扫描了一间会议室,得到包含桌椅、墙面和其他物体的点云。传统 3D 语义分割模型会为每个点分配一个类别,但这些类别通常在训练时就已经固定。如果想临时增加一个类别,模型往往需要新的标注和训练,但开放词汇 3D 语义分割希望改变这一点:给定一组类别文本,模型能够在点云中找到与这些文本对应的区域。
目前,二维视觉语言模型已经积累了丰富的图像和语言知识,把这些能力迁移到三维空间,是一条自然的路线。问题在于,二维预测也会出错。一把椅子的椅背可能被遮挡,桌子边缘可能混入地面的特征,同一个物体从不同视角看也可能得到不一致的语义表示。如果 3D 模型只追着这些二维特征学习,二维错误也会一起进入点云。
GeoGuide 关注的正是这个问题:三维点云本身具有几何结构,能否用这些结构来约束知识迁移,让模型判断哪些二维信息更可信、哪些区域应该保持一致?
1. 背景:开放词汇能力如何进入三维空间
1.1 从固定分类头到文本匹配
传统闭集语义分割通常使用固定分类头,输出训练时定义好的类别。开放词汇方法则尝试把点云特征与文本特征放到一个可以比较的空间中。
设点
这样,候选类别集合
CLIP 提供了图像与文本之间的对齐能力,LSeg、OpenSeg 等方法进一步提供像素级的语言对齐特征。需要区分的是,原始 CLIP 本身并不是一个逐像素分割模型。相比丰富的图文数据,大规模、高质量的点云—文本配对数据更难获取。因此,许多工作选择从二维模型获得监督信号。论文将相关方法概括为两条主要路线。
1.2 路线一:2D 到 3D 的特征蒸馏
典型流程是:先提取多视图图像的像素级语义特征,再利用相机参数和深度信息建立像素与点云的对应关系,最后训练 3D 网络去拟合投影到点云上的二维特征。OpenScene 是这条路线的代表。
这里有两个容易忽略的细节:
- 第一,多视图图像可以来自实际
RGB-D采集,并不一定是把点云重新渲染成图片; - 第二,点与像素之间不是简单的一一对应:一个点可能被多个视角观测,也可能被遮挡而没有有效观测。
蒸馏的优势在于监督足够细,可以把像素级知识传到点级。但二维模型的边界模糊、视角偏差和误识别,也会污染监督目标。即使投影关系准确,正确的几何对应也无法保证被投影的语义特征正确。
1.3 路线二:点—文本对齐
另一类方法先构造点云区域与文本的配对,例如通过对应图像生成区域描述,再用对比学习拉近相关点云区域和文本的表示。这条路线更直接地建立了点云与语言的联系,不过监督仍可能依赖二维图像或由其生成的描述。区域对应错误、描述不完整,同样会影响训练。
两条路线都有利用三维几何的空间。更准确地说,已有方法对几何结构的利用程度不同,仅依赖跨模态对齐目标,往往不足以显式维护三维表示内部的结构关系。
2. 动机实验:有预训练几何特征,为什么还不够
既然二维监督可能不可靠,一个直观办法是引入预训练 3D 模型。它已经从大量点云中学到了局部形状和物体结构,或许只需要一个小的适配器,就能把这些特征映射到语言对齐空间。
作者先做了这个尝试:冻结预训练 3D 骨干,仅训练一个两层 MLP 组成的 3D–2D Adapter,并与 OpenScene 的直接蒸馏方案比较。
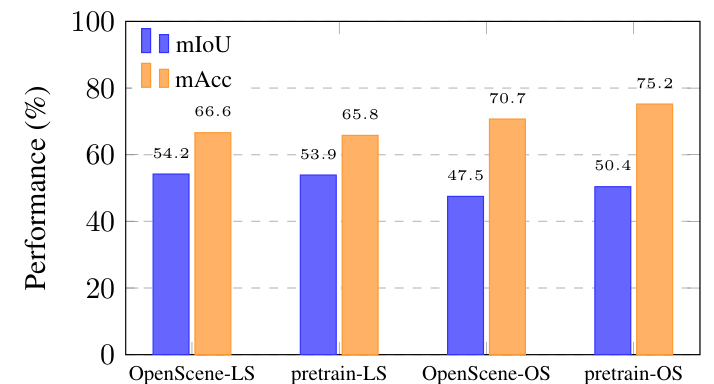
图 1:动机实验,来源为论文 Figure 3。LS 表示 LSeg,OS 表示 OpenSeg。
| 二维特征来源 | 训练方案 | mIoU | mAcc |
|---|---|---|---|
| LSeg | OpenScene | 54.2 | 66.6 |
| LSeg | 冻结预训练骨干,仅训练 Adapter | 53.9 | 65.8 |
| OpenSeg | OpenScene | 47.5 | 70.7 |
| OpenSeg | 冻结预训练骨干,仅训练 Adapter | 50.4 | 75.2 |
OpenSeg 设置下,预训练方案带来了 2.9 个百分点的 mIoU 提升;LSeg 设置下,mIoU 则下降了 0.3 个百分点。这个实验支持的结论是:引入预训练几何特征有潜力,但简单地把它们映射到二维特征空间,并不能稳定带来收益。
原因可以从两个角度理解:
- 其一,三维几何表示与二维视觉语言表示的组织方式不同,对齐本身存在难度;
- 其二,二维教师提供的目标包含噪声,适配器可能为了拟合噪声而改变输出特征的相对关系。
这里需要准确理解“几何先验退化”:在冻结骨干的设置下,骨干参数不会被训练改坏。更直接的问题是,适配后的语义表示未必保留原始几何表示中的关系。动机实验展示了性能差异,但没有单独隔离并证明每一种原因。另外,不能把这组实验理解成“OpenSeg 总比 LSeg 强”。两者在不同数据和指标上的表现不同;LSeg 和 OpenSeg 所对应的论文也都发表于 2022 年。
3. 整体架构:几何先验参与监督的三个层次
GeoGuide 的设计可以围绕一个问题展开:语义一致性应该约束到多大范围?
| 层次 | 希望解决的问题 | 对应模块 |
|---|---|---|
| 超点内部 | 一个局部几何区域中的二维特征有噪声、互相冲突 | USD:基于不确定性的超点蒸馏 |
| 单个实例内部 | 一个物体的不同部分得到碎片化的语义表示 | IMR:实例级掩码重构 |
| 实例之间及超点之间 | 相似区域因视角差异产生不同的语义关系 | IIRC:实例间关系一致性 |
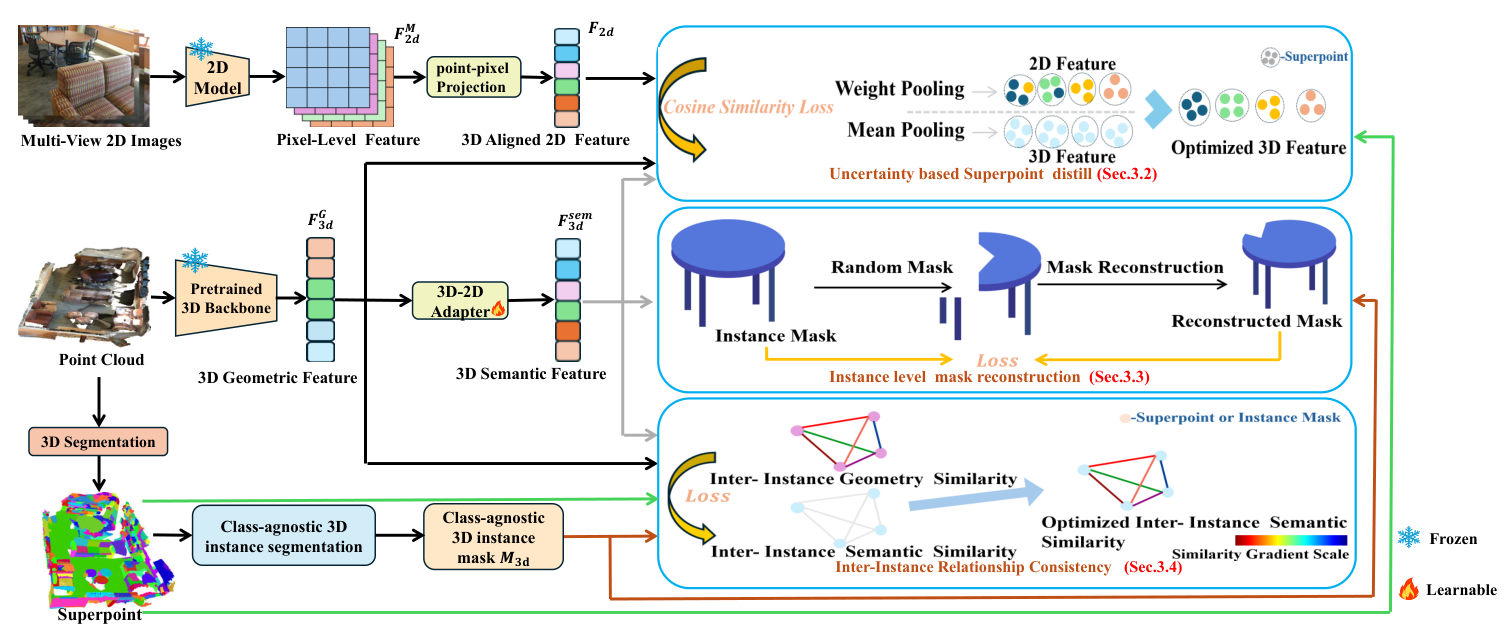
图 2:GeoGuide 总体架构,来源为论文 Figure 2。图中的冻结标记对应二维模型和预训练三维骨干,Adapter 负责产生语言对齐的三维语义特征。
3.1 三类特征分别是什么
为了避免后面混淆,先明确论文中的三类特征。设场景有
| 符号 | 含义 | 形状 |
|---|---|---|
|
|
冻结的预训练 3D 骨干输出的几何特征 |
|
|
|
多视图二维语义特征投影、融合后的点级特征 |
|
|
|
Adapter 输出的三维语义特征 |
|
其中:
3.2 二维特征怎样对应到点云
对一个三维点
对于有多个有效视角的点,论文沿用 OpenScene 的处理,对相应二维特征做平均融合。
这个过程解决的是“哪个像素能对应这个点”。接下来的 USD 处理“这些已经对应到点上的二维特征,哪些更值得相信”。两者作用不同。
3.3 超点与实例的区别
超点是通过几何过分割得到的局部区域,内部通常具有相近的几何属性。一个超点可能只覆盖椅背的一部分;同一把椅子往往包含多个超点。
实例掩码则希望覆盖一个完整物体。GeoGuide 采用基于法向量的过分割生成超点,并借助 SAI3D 获取类别无关的 3D 实例掩码。
“类别无关”意味着这些掩码提供的是“哪些点属于同一个物体”,不需要同时给出“它是椅子还是桌子”的类别标签。它们属于方法生成的结构监督,而非人工标注的真实实例掩码。
4. USD:先让局部区域获得更可靠的语义监督
USD 的全称是 Uncertainty-based Superpoint Distillation,即基于不确定性的超点蒸馏。
考虑一个桌面超点:多数点从二维图像中获得了桌面的特征,少数边缘点却混入地面的信息。直接逐点蒸馏,会把这些错误也学进去;如果把所有二维特征简单平均,错误虽然被平滑,却仍会污染整个区域的监督目标。
USD 的思路是:结合几何和语义的局部差异,为每个点预测一个可靠性权重,再聚合出更合适的超点级教师特征。
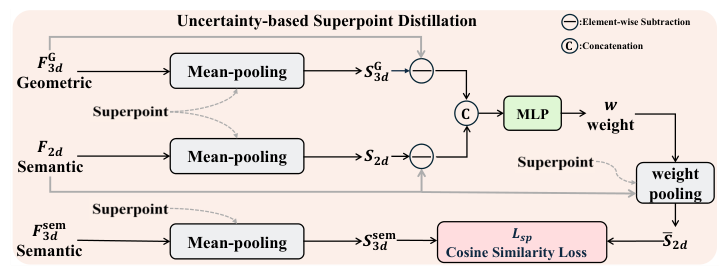
图 3:USD 模块,来源为论文 Figure 4。
4.1 从点与区域的差异估计可靠性
设第
以及同样方式计算的
对于超点中的点
这是原文公式(2)的逐点写法。公式中超点特征需要广播到其包含的各个点,才能执行相减。
直观上,模型可以同时参考:这个点在几何上是否符合局部结构,以及它的二维语义是否偏离局部区域。比如一个点的几何表示与周围很一致,二维语义却明显不同,就有理由降低这份二维监督的影响。
不过,
4.2 加权聚合后,同时约束超点和点
用预测的权重在超点内部聚合二维特征:
其中
蒸馏损失包含两部分。将原文公式(4)中的集合归约显式写成平均,可表示为:
第一项约束超点的整体语义,第二项约束内部各点的语义。值得注意的是,第二项的目标也是经过加权聚合、再映射回点级的二维特征,并不是直接使用最初的噪声特征。
因此,USD 对蒸馏做了两件事:调整教师特征的聚合方式,并把局部几何区域作为语义一致性的基本单元。
它也依赖一个前提:超点应该尽量不跨越语义边界。如果过分割把两个不同物体混在一起,强制它们保持一致就可能有副作用。
5. IMR:从物体的部分表示找回整个实例
USD 的作用范围是超点,一个完整物体却可能跨越多个超点。例如椅背和椅座各自预测稳定,仍可能被分到不同类别。IMR 将约束扩大到实例层面。
IMR 的全称是 Instance-level Mask Reconstruction,即实例级掩码重构。
5.1 输入是部分实例,监督目标是完整掩码
设 SAI3D 提供的完整实例掩码为
再用
最终,预测结果与遮挡前的完整掩码比较:
这里使用的是保留下来的部分构建查询,而不是从已遮掉的部分提取特征。
5.2 为什么这能约束语义
以椅子为例,即使只用椅背上的点构建查询,训练仍要求模型找回完整椅子的掩码。为完成这个任务,椅座、椅腿等部位的特征需要与查询具有足够的关联,其他物体则需要被区分开。因此,IMR 鼓励同一实例的不同部位形成一致且可区分的表示,减轻二维视角不完整带来的语义碎片化。
这里的“重构”特指在已有场景点上恢复掩码归属。它不会生成新的三维坐标,也不等同于补全扫描中根本没有采集到的表面。
6. IIRC:让语义表示保留几何关系
前两个模块分别处理局部区域和单个物体。接下来还有一个问题:场景中两把结构相似的椅子,因为视角、遮挡或光照不同,可能获得不同的二维特征,最后被映射到相距较远的语义位置。
IIRC 的全称是 Inter-Instance Relation Consistency,即实例间关系一致性。它希望适配后的语义空间保留几何空间中的区域关系。
6.1 约束“彼此之间的关系”
首先用实例掩码分别池化几何特征和三维语义特征,得到实例级嵌入:
按原文公式(8),两组关系矩阵由特征内积构成:
矩阵的第
这种设计把监督从“单个区域的特征应该是什么”扩展到了“不同区域应该如何相互关联”。它不需要预先知道哪两个实例具有相同的类别标签,而是用预训练几何特征提供软性的关系参照。
6.2 同时约束实例之间和超点之间
虽然模块名字强调实例,原文实际上还在超点层面建立了几何与语义关系矩阵。因此,完整损失为:
MSE 是均方误差,不是均方根误差。它让语义关系矩阵接近几何关系矩阵,同时在实例和超点两个粒度上保留结构信息。
这里也应保留一个边界:几何相似只是语义相似的先验。同样是细长的杆状结构,可能对应不同物体;同一类别内部也可能存在很大的形状差异。所以 IIRC 提供的是关系约束,而非“形状相似就一定同类”的硬规则。
7. 训练与推理:复杂约束留在训练阶段
GeoGuide 将三个目标组合起来:
这三个目标的分工是清楚的:USD 改善局部监督,IMR 约束实例内部,IIRC 维护区域之间的关系。它们共同约束 Adapter 输出的三维语义表示。
推理时,三个几何引导模块被移除。场景点云经过冻结的 3D 骨干和训练后的 Adapter,产生逐点语义特征,再与 CLIP 文本编码器生成的类别特征匹配:
因此,“推理只需要点云”是指不再需要场景的多视图图像、二维教师特征和实例掩码等辅助输入;用于匹配的候选类别文本或预先算好的文本嵌入仍然需要。
这也是方法一个实际的优点:几何约束虽然增加了训练流程,但不会要求部署时重新运行整套二维特征提取和掩码生成流程。
8. 实验:收益体现在哪里
论文在 ScanNet v2、Matterport3D 和 nuScenes 上评估,分别覆盖室内扫描场景与室外驾驶场景。ScanNet v2、nuScenes 使用验证集结果,Matterport3D 使用测试集结果。
指标主要是 mIoU 和 mAcc,均以百分数报告。mIoU 对每个类别的交并比取平均,同时考虑误检和漏检;mAcc 对每个类别中预测正确的点比例取平均。它们不同于把所有点混在一起计算的总体准确率。
论文将这些实验归为 annotation-free / zero-shot 设置。这里应理解为不使用目标任务的人工 3D 语义标注进行训练,不能据此推断整个系统及其预训练模型从未使用过任何标注或配对数据。
8.1 主结果:不同二维特征下都能带来改善
以下摘录原文 Table 1 的 mIoU。为便于比较,统一按 ScanNet v2、nuScenes、Matterport3D 排列。
| 方法 | ScanNet v2 | nuScenes | Matterport3D |
|---|---|---|---|
| OpenScene(LS)‡ | 54.2 | 36.7 | 43.4 |
| GeoGuide(LS) | 59.8 | 40.4 | 47.8 |
| OpenScene(OS)‡ | 47.5 | 42.1 | 42.6 |
| GeoGuide(OS) | 53.4 | 47.5 | 47.7 |
| SAS,stage 1 | 59.2 | 45.4 | 46.3 |
| SAS,stage 2 | 61.9 | 47.5 | 48.6 |
| GeoGuide(SAS*) | 64.8 | 50.3 | 51.9 |
‡ 表示使用 2D–3D 集成。SAS* 表示使用与 SAS 相同的二维特征配置:室内采用 LSeg + SEEM,室外采用 OpenSeg + SEEM。GeoGuide 报告的是纯 3D 分支推理结果。
以 ScanNet v2 为例,GeoGuide 相比对应 OpenScene 结果,在 LSeg 和 OpenSeg 下分别提升 5.6、5.9 个 mIoU 百分点。这说明收益不局限于某一个二维教师。
采用 SAS* 特征时,相比 SAS stage 1,三个数据集上的提升分别是 5.6、4.9、5.6 个百分点;相比更强的 SAS stage 2,则分别提升 2.9、2.8、3.3 个百分点。将两种比较基准分开,才能准确理解增益规模。
对应的 GeoGuide(SAS*)mAcc 分别为 77.3、74.2、66.3。
这些结果支持几何引导在论文评估设置中的有效性,但不能理解为已经全面超过全监督方法。例如,同一张表中 PTv3 在 ScanNet v2 上达到 77.5 mIoU,仍高于 GeoGuide 的 64.8。不同方法的训练监督、预训练资源和推理方式也并不完全相同。
8.2 长尾评估:类别更多时,教师选择依然关键
在 Matterport3D 上,作者将候选类别数量扩展到
下表摘录原文 Table 2 的 mIoU:
| 方法 | 21 类 | 40 类 | 80 类 | 160 类 |
|---|---|---|---|---|
| OpenScene(OS)‡† | 42.6 | 34.4 | 21.0 | 10.9 |
| DMA(OS) | 45.1 | 37.9 | 19.7 | 9.4 |
| SAS† | 48.6 | 22.5 | 12.3 | 6.1 |
| GeoGuide(LS) | 47.8 | 33.7 | 18.4 | 9.6 |
| GeoGuide(OS) | 47.7 | 38.5 | 22.0 | 11.6 |
| GeoGuide(SAS*) | 51.9 | 33.8 | 19.9 | 9.3 |
† 表示论文作者使用官方权重复现的结果,‡ 表示 2D–3D 集成。
这张表有两点值得注意。
首先,GeoGuide 在表中各类别规模的最佳结果都高于所列对比方法,但不同规模的最佳配置并不相同:21 类时 SAS* 最好,40、80、160 类时则是 OpenSeg 最好。基础类别上的优势,不能直接等同于更大词汇表上的优势。
其次,类别扩展仍然带来明显困难。GeoGuide(OS)的 mIoU 从 47.7 降到 11.6,说明长尾与细粒度区分远没有被解决。几何约束能够改善结果,但二维教师的语义覆盖和类别区分能力仍然重要。
8.3 跨数据集迁移:几何先验具有一定可迁移性
论文还测试了不微调的双向迁移。以下是原文 Table 3、Table 4 中 SAS 与 GeoGuide(SAS*)的 mIoU 对比:
| 训练集 → 测试集 | SAS† | GeoGuide(SAS*) | 提升 |
|---|---|---|---|
| ScanNet v2 → Matterport3D,21 类 | 43.0 | 50.1 | +7.1 |
| Matterport3D → ScanNet v2 | 44.3 | 57.2 | +12.9 |
这里的提升与“几何结构相对不易受外观变化影响”的解释一致,支持方法在两个室内数据集之间的迁移能力。不过,这些结果不等于已经验证了任意跨域场景,例如室内训练后直接迁移到室外驾驶。
8.4 定性结果:关注物体内部和边界
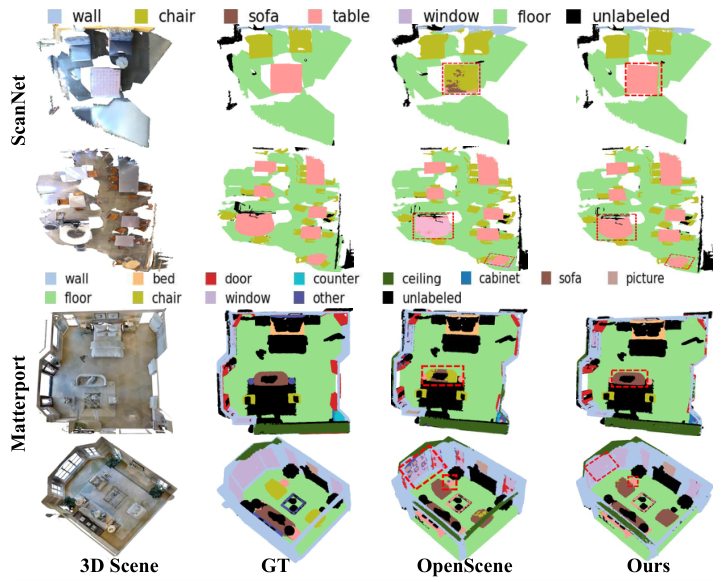
图 4:论文 Figure 5。各列依次为场景、真实标注、OpenScene 和 GeoGuide。
阅读这组图时,可以重点看同一物体内部是否存在零碎的类别斑块,以及相邻物体之间的边界是否更清楚。图中标出的区域展示了 GeoGuide 在这些方面的改善,与局部、实例级一致性的设计目标相符。
不过,可视化只展示少量场景,整体效果仍需结合定量结果判断。
9. 消融实验:预训练和三个模块各自贡献了什么
消融在 ScanNet v2 验证集上进行,统一使用 LSeg 作为二维特征来源。以下整理自原文 Table 5,方案说明结合第 4.3 节。
| 组别 | 方案 | mIoU | mAcc |
|---|---|---|---|
| A | OpenScene 基线 | 54.2 | 66.6 |
| B | 不加载预训练权重,从头训练所选 3D 骨干 | 53.1 | 63.9 |
| C | 引入预训练骨干,不增加几何一致性模块 | 53.9 | 65.8 |
| D | 加入普通超点蒸馏 SD,使用平均池化 | 55.8 | 67.2 |
| E | 加入 USD | 56.4 | 68.3 |
| F | 加入 IMR | 56.8 | 68.9 |
| G | USD + IMR | 57.9 | 70.5 |
| H | 加入 IIRC | 57.1 | 69.3 |
| I | USD + IMR + IIRC | 59.8 | 72.5 |
仅靠预训练还不够。 B 到 C 的 mIoU 从 53.1 提升至 53.9,但 C 仍略低于 A 的 54.2。最终方法的收益不能简单归结为“换了一个预训练骨干”。
超点聚合有用,自适应权重进一步改善结果。 D 达到 55.8,说明普通区域聚合本身就有帮助;E 达到 56.4,相比 D 再提升 0.6 个百分点。这是支持 USD 加权设计的直接对照。
局部一致性和实例一致性具有互补性。 E、F 分别为 56.4、56.8,组合后的 G 达到 57.9;在 G 的基础上加入 IIRC,完整方案达到 59.8,又增加了 1.9 个百分点。
相对 A,完整方法提升 5.6 个 mIoU 百分点;相对 C,则提升 5.9 个百分点。整体结果支持分层约束的组合效果。
同时,这张表没有给出所有可能的两两组合,也没有报告多次运行的方差。因此,可以说所列模块和组合有效,不宜把各个增益当成完全独立、可直接相加的贡献,也无法单凭这些数据判断统计显著性。
10. 如何评价这项工作
以下是基于方法与实验的阅读分析,区别于作者直接报告的实验结论。
10.1 最有价值的设计:让结构参与知识迁移
GeoGuide 把预训练三维几何特征用在了多个位置:USD 借助几何差异评估二维监督的可靠性,IMR 借助实例结构组织语义学习,IIRC 则直接约束几何与语义的关系矩阵。
这使几何先验成为训练过程中的参照,而不只是 Adapter 的输入。尤其是 IIRC,它约束区域之间的相对关系,给跨模态映射保留了比逐点拟合更明确的结构要求。
从更一般的角度看,这项工作提供了一种值得借鉴的思路:在跨模态蒸馏中,目标模态已有的结构知识,可以用来筛选和组织教师提供的监督。
10.2 几何监督的质量仍是前提
超点和实例掩码都可能出错。如果超点跨越语义边界,USD 可能把不同类别拉到一起;如果实例掩码把两个物体合并,IMR 会学习错误的完整性目标,IIRC 的区域关系也会受到影响。
因此,方法并没有消除对伪监督质量的依赖,而是引入了几何结构来改善语义监督。它能在多大程度上抵抗错误掩码,还需要更有针对性的实验。
10.3 推理简洁,训练成本仍需单独评估
推理阶段移除三个引导模块,是架构上的明确优点。但训练仍需要多视图特征、点像素对应、超点和实例掩码。
此外,完整关系矩阵随区域数量呈平方增长。若超点数量为
原文说明实验使用单张 NVIDIA A6000 GPU,室内外体素尺寸分别为 2 cm 和 5 cm,优化器为 AdamW、batch size 为 4。但所给 v1 正文没有提供完整的耗时、显存和速度对比,无法仅凭“轻量 Adapter”判断整体成本。
10.4 方法原理与实现细节应分开看
论文正文清楚给出了三个模块的目标,但部分实现细节仍需补充材料或代码确认,包括损失权重、随机遮挡比例、USD 权重的具体归一化,以及 IIRC 中特征是否进行归一化。
IMR 也有一个值得复现时核查的细节:按原文公式直接对余弦相似度使用 sigmoid,输出范围约为
这些细节不妨碍理解方法,但会影响复现时对数值行为的判断。
11. 结语
GeoGuide 提出的核心问题是:二维模型可以提供丰富的语义知识,三维模型在接收这些知识时,也应该保留对自身结构的判断。
它用超点蒸馏改善局部监督,用实例掩码重构连接物体不同部位,再用关系一致性维护区域之间的几何联系。实验表明,这些约束能够共同改善开放词汇分割,并在论文测试的跨数据集设置中带来收益。
对我而言,这篇论文最值得记住的是:跨模态对齐的质量,不只取决于特征距离是否更小,也取决于映射之后是否保留了有用的结构关系。
参考与阅读说明
- Xujing Tao et al. GeoGuide: Hierarchical Geometric Guidance for Open-Vocabulary 3D Semantic Segmentation. arXiv:2603.26260v1, 2026. 论文页面。本文的方法、公式及实验数据均以该版本为准。
- Songyou Peng et al. OpenScene: 3D Scene Understanding with Open Vocabularies. CVPR 2023。对应 GeoGuide 原文参考文献 [57]。
- Xiaoyang Wu et al. Sonata: Self-Supervised Learning of Reliable Point Representations. CVPR 2025。对应原文参考文献 [74]。
- Yingda Yin et al. SAI3D: Segment Any Instance in 3D Scenes. CVPR 2024。对应原文参考文献 [79]。
- Boyi Li et al. Language-driven Semantic Segmentation. 2022。对应 LSeg,原文参考文献 [36]。
- Golnaz Ghiasi et al. Scaling Open-Vocabulary Image Segmentation with Image-Level Labels. ECCV 2022。对应 OpenSeg,原文参考文献 [24]。