接到郑哥发来的offer后,我立马就赶来了杭州,当天4月23日上午10准时报道,在跟研怡姐姐一起签署了实习协议,了解了公司的保密制度和物件使用管理规定后,王哥(也就是我的面试官,同时兼任公司的带教导师)前来接待,然后带我参观了物品算法部门,认识了部门和组内(我们组叫 Mars) 的各位前辈,大家都很热情。上午安排完工位后,就跟组内同时吃饭去了,这次是王哥买的单 emi=oji,下午因为刚入职,相关权限还未开通(后面一直持续了两天:大华的权限、华昱欣的权限等等),暂未安排我具体工作,但了解到每周的日常事务以及活动情况:
- 周四:组内会议(13:45)、部门会议(16:30)、羽毛球赛(19:00)
- 周六/日:团建 / 公费旅游
- 先进研究院活动、公司社团活动
总体来看公司在员工的生活和社交方面是比较重视的。后面两天公司给我开通了:所在小组的gitlab权限、git操作权限、外网权限(公司电脑是连接内网进行工作的)、巨灵训练平台 JINN、A40 GPU,就开始正式工作了。
在这一个多月的实习里,我在公司主要做了如下几件事情:
1、熟悉公司25年研发的Agent智能助手V1.1项目
通过王哥发来的算法说明文档,了解到智能助手的各类核心模块,包括意图识别、知识库查询、数据库查询、任务拆解、图表生成、问题回复、文档索引及界面索引等,并跑通了demo,并重点梳理了项目中服务端进程Server_daemon.py与测试文件test_request.py之间的交互逻辑及数据流转机制。这种模块化分解设计,不仅能丰富用户使用体验,还便于后续对智能助手功能进行拓展升级及模块迭代更新。其各模块具体如下:
-
语音识别:目前暂未实现相关功能。
-
意图理解/任务拆解:可基于用户提出的问题,精准拆解核心需求并给出对应回复,为后续ReAct架构的搭建奠定基础。
-
数据库查询:主要用于查询公司内部发用电数据、设备信息等相关数据。
-
图表生成:能够根据用户具体请求,自主选择合适的图表类型,并向平台发起调用请求,完成图表生成。
-
界面索引:可根据用户需求,自主对相关界面进行索引匹配,提升使用便捷性。
-
文档索引:输出相关参考资料,方便用户自行查询对应文档,获取更详细信息。
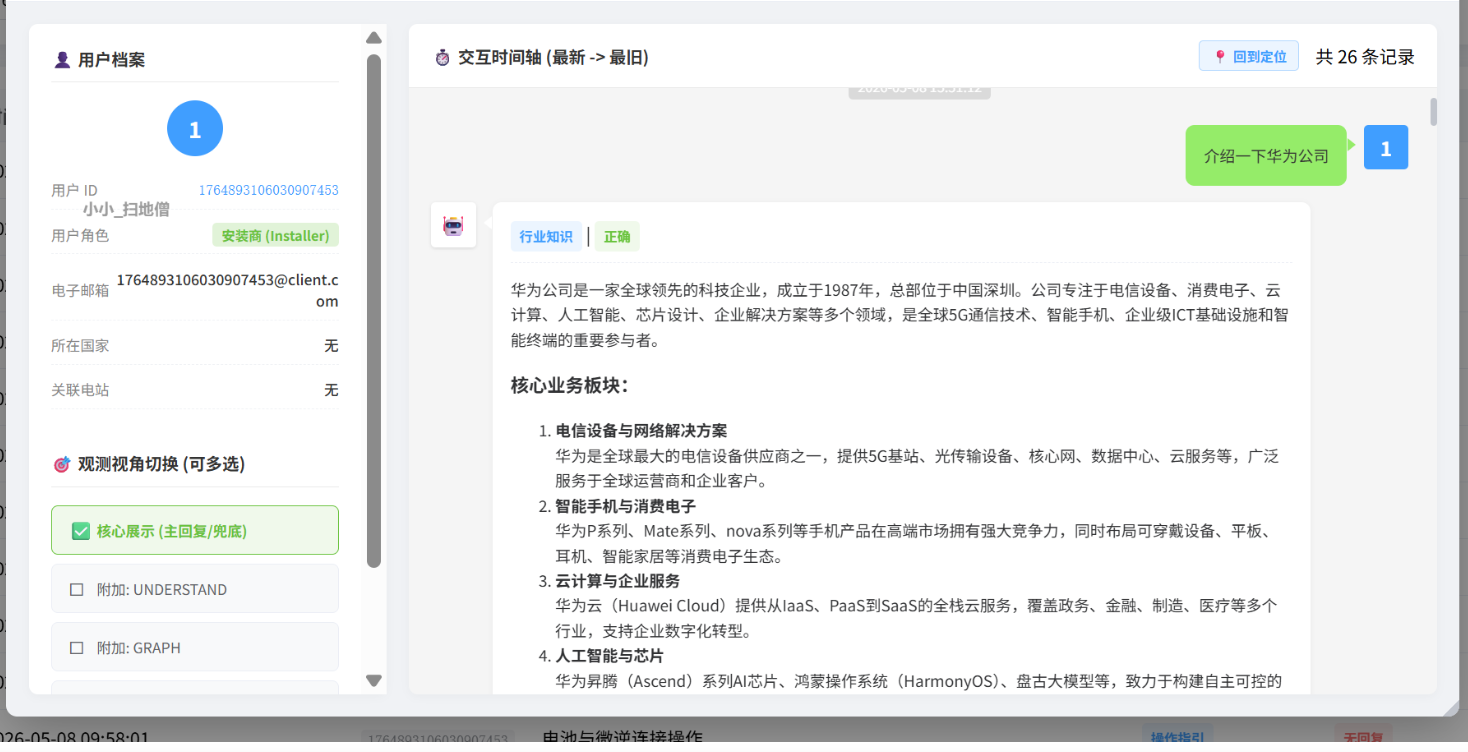
目前我的核心工作聚焦于智能助手相关的日志解析及文档VLM识别相关任务,当时能够基于公司给出的后台日志内容,完成任务分类工作,具体包括:操作指引、产品咨询、功能解答、行业知识、客诉宣泄、闲聊无效等类别。
2、Agent 智能助手后台日志解析系统
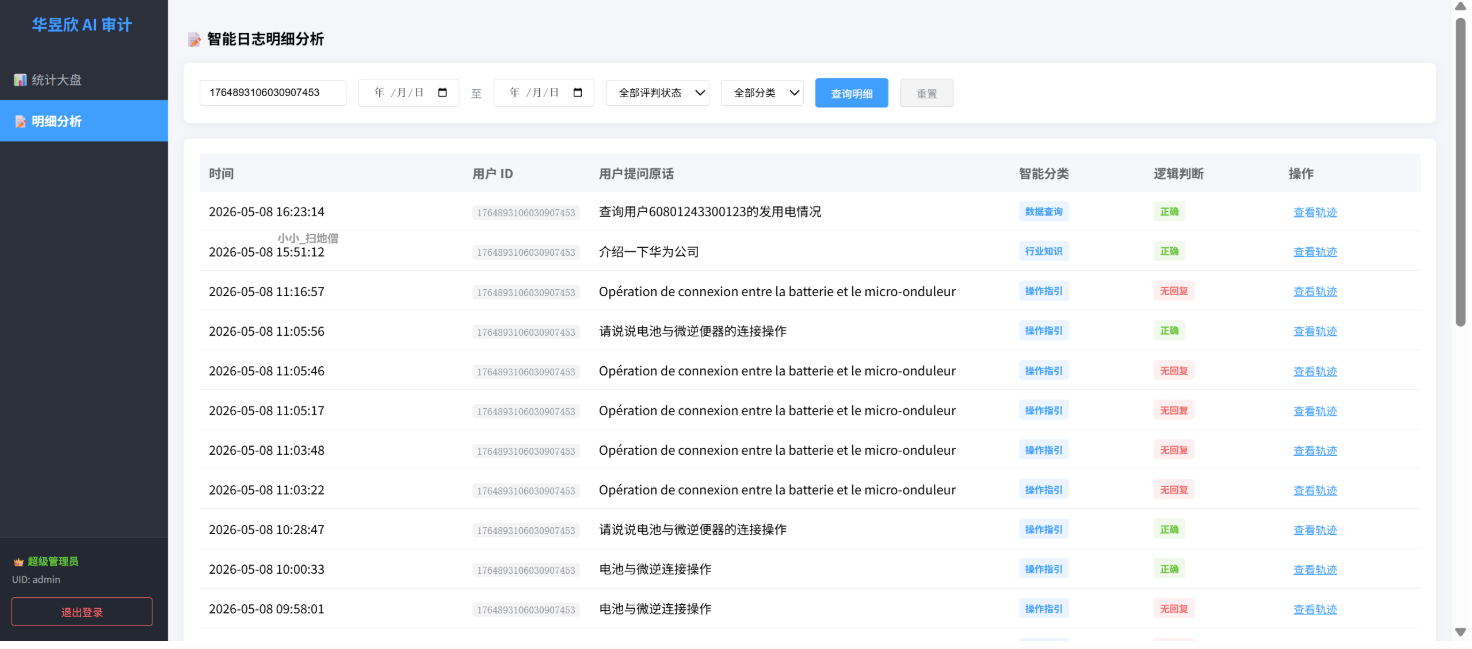
这个日志解析系统刚开始并不是一个有完整需求的事情,因为当时王哥只是要求我基于logs、logs_details目录下的日志内容进行聚合分析,然后对用户的输入进行实现任务分类、对智能助手回复的内容结合用户输入来进行逻辑性分析。当时只是讲这个需求写成了一款日志分析工具,能够在公司特定日志目录下,用fastapi暴露借口给其他设备进行日志的提取与解析(可能是我当时理解错王哥的意思了),后来重新改了一版确定了具体的需求:做一款基于公司Agent助手的后台日志内容,来对用户的使用情况进行分析,统计各个时间段的使用量以及用户使用公司产品遇到的售后问题 / 用户客诉等等,以便即使与客户进行沟通、反馈。
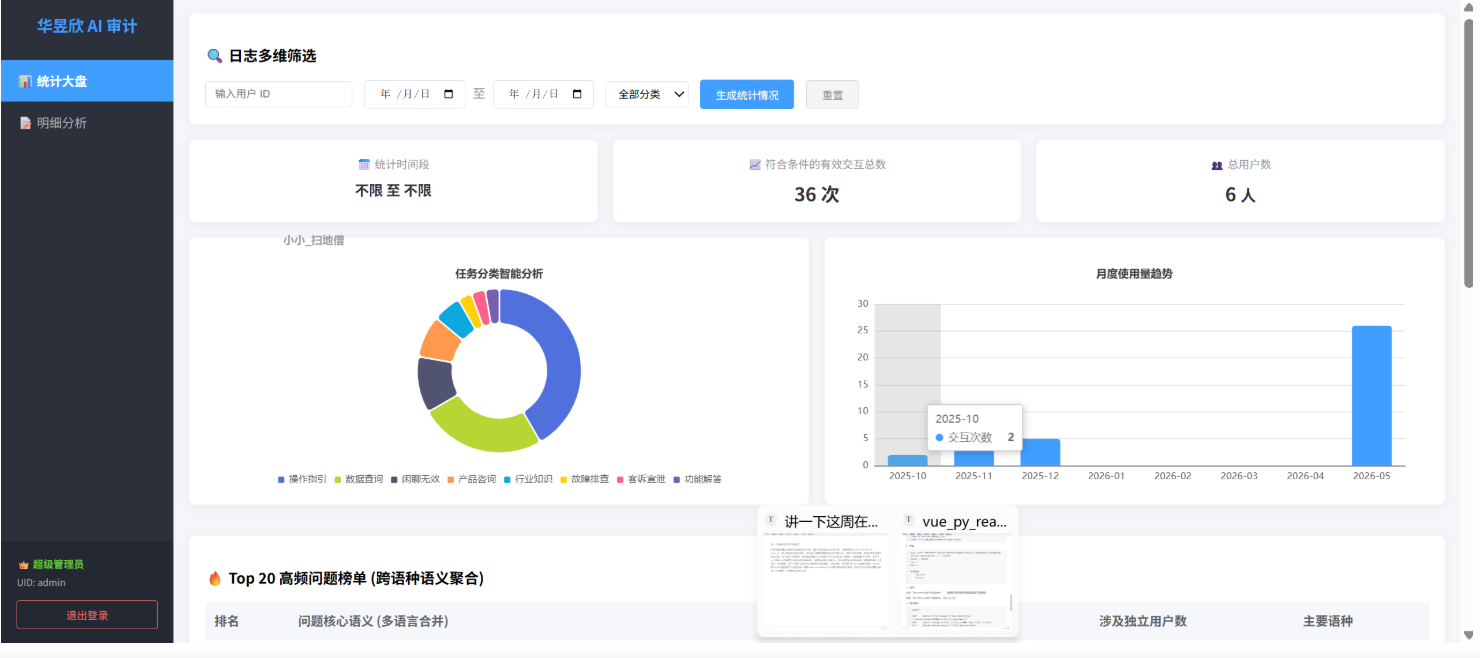
项目介绍: Vue3 前端 + Python 后端 的前后端分离结构,给日志分析做了可视化界面,支持:
- 支持按时间、任务类型、用户 ID 等条件筛选日志
- 后台定时分析日志,进行任务分类等
- 自动生成统计报表,包含柱状图、饼图、TOP20 高频问题 (faq) 等展示(其中 TOP20 功能用到千问 qwen-embedding-0.6b 词嵌入模型做日志语义聚类)
1 | log/ |
以下是当时写的周报内容:
【AI助手运维后台开发】
需求背景:
1、响应agent助手后台运维人员对用户交互记录的需求,无系统交互记录的可视化效果,难以快速追溯用户具体问答内容,不能及时的对用户反馈异常、客诉等问题等进行排查,由此针对性的进行了AI助手运维后台的开发,支撑运维人员常态化查看用户的全量交互记录当前进度:
1、针对助手实时产生的用户交互日志,搭建定时自动化分析任务,配置固定时间周期轮询扫描新增日志数据,在减低系统算力消耗的同时提升数据处理效率
2、基于用户交互的内容,完成日志任务的分类建设,将交互日志精准的划分为8个类别(操作指引、产品咨询、故障排查、功能解答等),解决原有日志信息无分类、数据杂乱的问题
3、利用qwen-embedding-0.6b 词嵌入模型对用户输入信息进行语义提取、进行相似度计算,实现高频数据榜单的可视化展示,提升问题分析的工作效率后续计划:
1、引入向量数据库对日志的语义聚合的功能进行优化
2、加上页面缓存,优化后台访问性能
3、AI 调度数据采集一键运行脚本
这份工作主要是根据先进研究院数据部同时传来的视频,通过对视频使用VLM进行识别和读取,来提取友商电站(如:van Velzen)的历史真实数据以及预测数据,包括发电功率、用电功率、电池充放功率、电网购售功率、买电价格、卖电价格、电池SOC等等
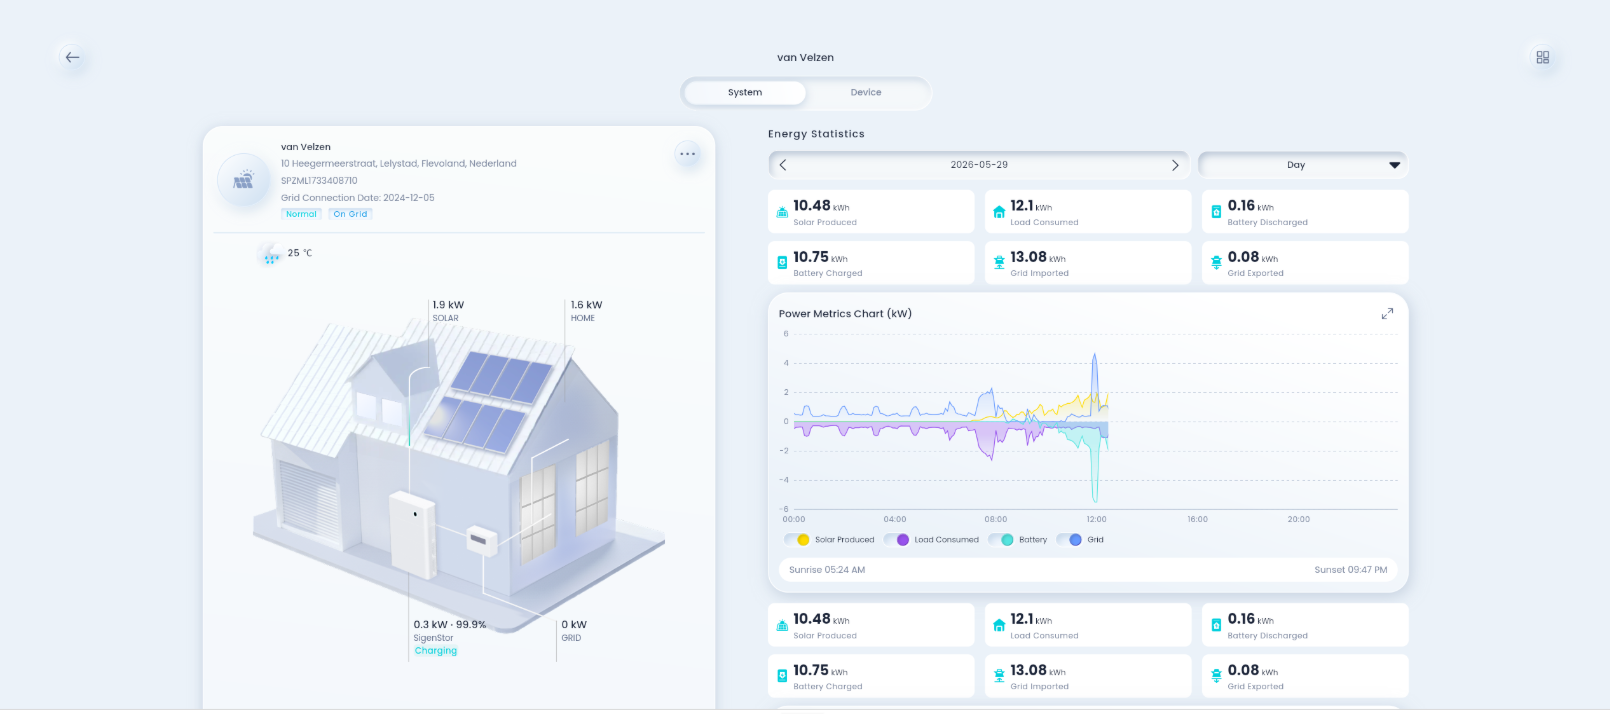
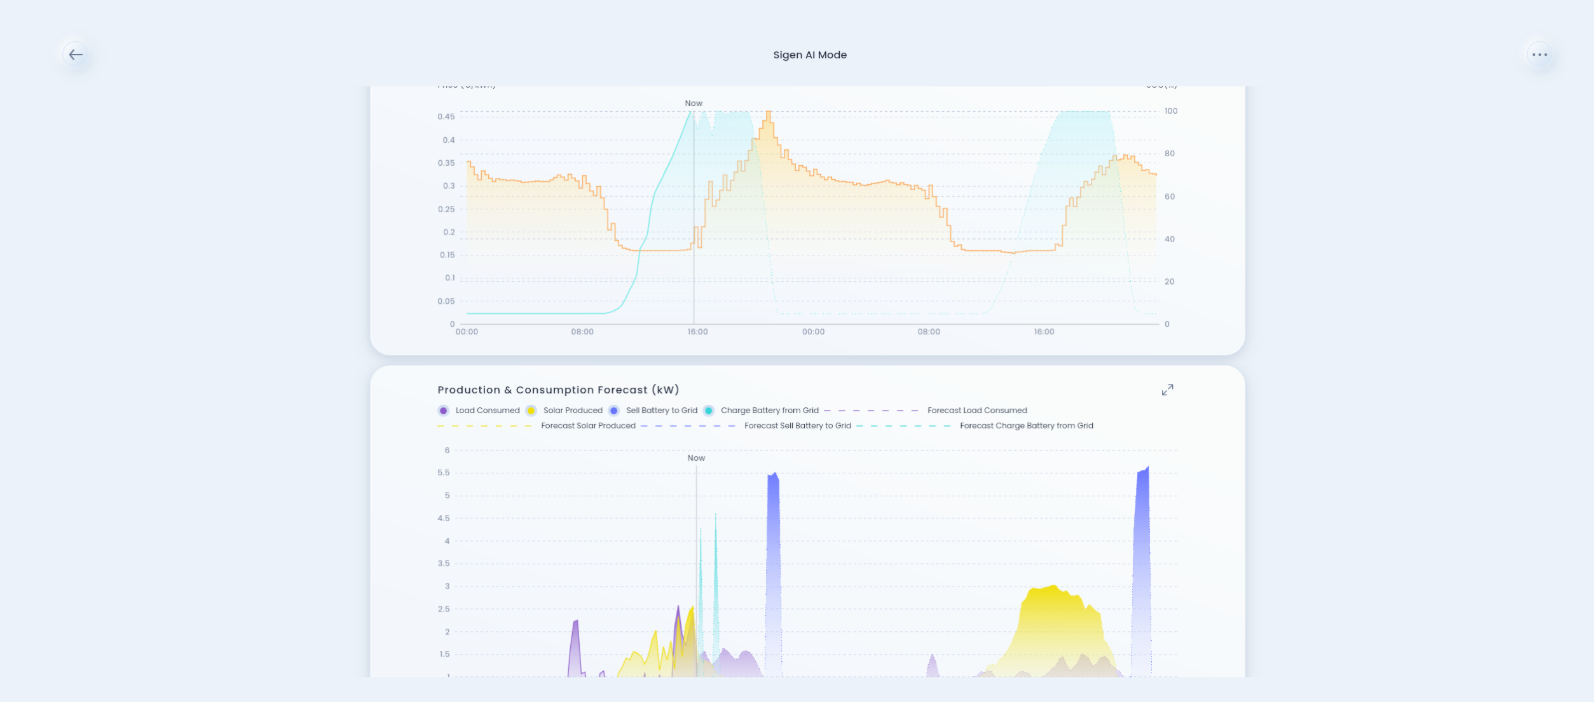
基本逻辑
先对录制的视频进行抽帧去重,然后使用视觉模型对每一有效帧图片进行分析并提取有效信息,最后写入excel文件,获取各电站的数据。
- 录制对应电站历史数据视频,并将视频分别放入对应电站的 run_history/inputs/power/、run_history/inputs/soc/ 文件夹下面(注意:power / soc 文件夹下分别只能放置一个对应的视频mp4文件)
- 录制对应电站预测数据视频,并将视频分别放入对应电站的 run_forecast/inputs/prod 、 run_forecast/inputs/soc 文件夹下面(注意:prod / soc 文件夹下分别放置前一天下班和当天上班时录制的视频mp4文件)
- 1、分开处理历史和预测视频:
- 执行 van_velzen/run_history/all_run_history.py:先清空run_history/temp_excel/ 下的文件,对power和soc的录制视频并行执行抽帧去重过程并写入各自的文件夹里面van_velzen/run_history/frames_his_power,van_velzen/run_history/frames_his_soc,然后对frames_his_power的帧图片进行处理生成并写入excel,后再对frames_his_soc的帧图片进行处理,最后把数据追加到对应excel文件中,最终输出到run_history/output_excel/ 下的 2026-xx-xx.xlsx 中
- 执行 van_velzen/run_forecast/all_run_forecast.py:先清空run_forecast/temp_excel/ 下的文件,对prod和soc的录制视频并行执行抽帧去重过程并写入各自的文件夹里面van_velzen/run_forecast/frames_his_power,van_velzen/run_forecast/frames_his_soc,然后对frames_fore_power的帧图片进行处理生成并写入excel,后再对frames_fore_soc的帧图片进行处理,最后把数据追加到对应excel文件中,最终输出到run_forecast/output_excel/ 下的 2026-xx-xx.xlsx 中
- 2、一个脚本跑完所有:执行 van_velzen/all.run.py,并行处理all_run_history.py 和 all_run_forecast.py, 最终输出的目录为各自run_history/output_excel/ ,run_forecast/output_excel/ 目录下
- 3、增量更新:如果发现处理完后的 excel 文件里存在数据缺失/错误的情况,找到 excel 文件中缺失的内容,在sigen网站上截取对应图片或者在录制的视频里面手动暂停来进行截取,将增量图片放入对应的 run_forecast/incre_image 或者 run_history/incre_image 目录下
- 进入对应的目录,run_forecast/ 或者 run_history/ ,执行增量脚本
- 历史增量: python incremental.py --excel output_excel/2026-xx-xx.xlsx 需要指定具体excel文件
- 预测增量: python incremental.py
最后再查看 output_excel/ 下的 excel 文件
待做清单(Todo)
-
脚本目前支持图片中对应英文字段内容的提取,暂不支持中文字段
- 可以修改对应提示词以进行适配,把第一段提示词改为下面的第二段,如下(这里以预测fore数据脚本 prod_fore.py为例):
1 | EXTRACT_PROMPT = |
- 也可以修改原提示词识别中文字段,再做一个map映射