本篇内容主要是弄清以下几个问题:
- 知道RAG、微调、智能体是什么以及它们分别都在解决什么问题
- 什么时候继续优化 Prompt,什么时候上 RAG,什么时候考虑微调,什么时候再引入工作流(Workflow)或 Agent
参考文档和资源如下:工具导航与参考资料索引、百度
一、判定问题根因
在真实的项目场景中,当我们发现AI应用,比如:各种私人的问答系统,回答不好时,一上来就说”要不要进行模型微调,要不要上Agent“,但在此之前我们需要对问题进行分析诊断才会稳很多:
| 诊断问题 | 常见现象 | 考虑 |
|---|---|---|
| 模型是不是没有看见资料? | 不知道公司产品手册、公告、制度,回答没有依据 | RAG |
| 模型是不是行为不稳? | 输出格式不统一、分类标签不稳、JSON经常错 | Prompt、必要时进行微调 |
| 任务需不需要多步分解执行? | 需要查资料,调接口、校验、重试 | 工作流或Agent |
如下图,AI应用落地的基本流程:
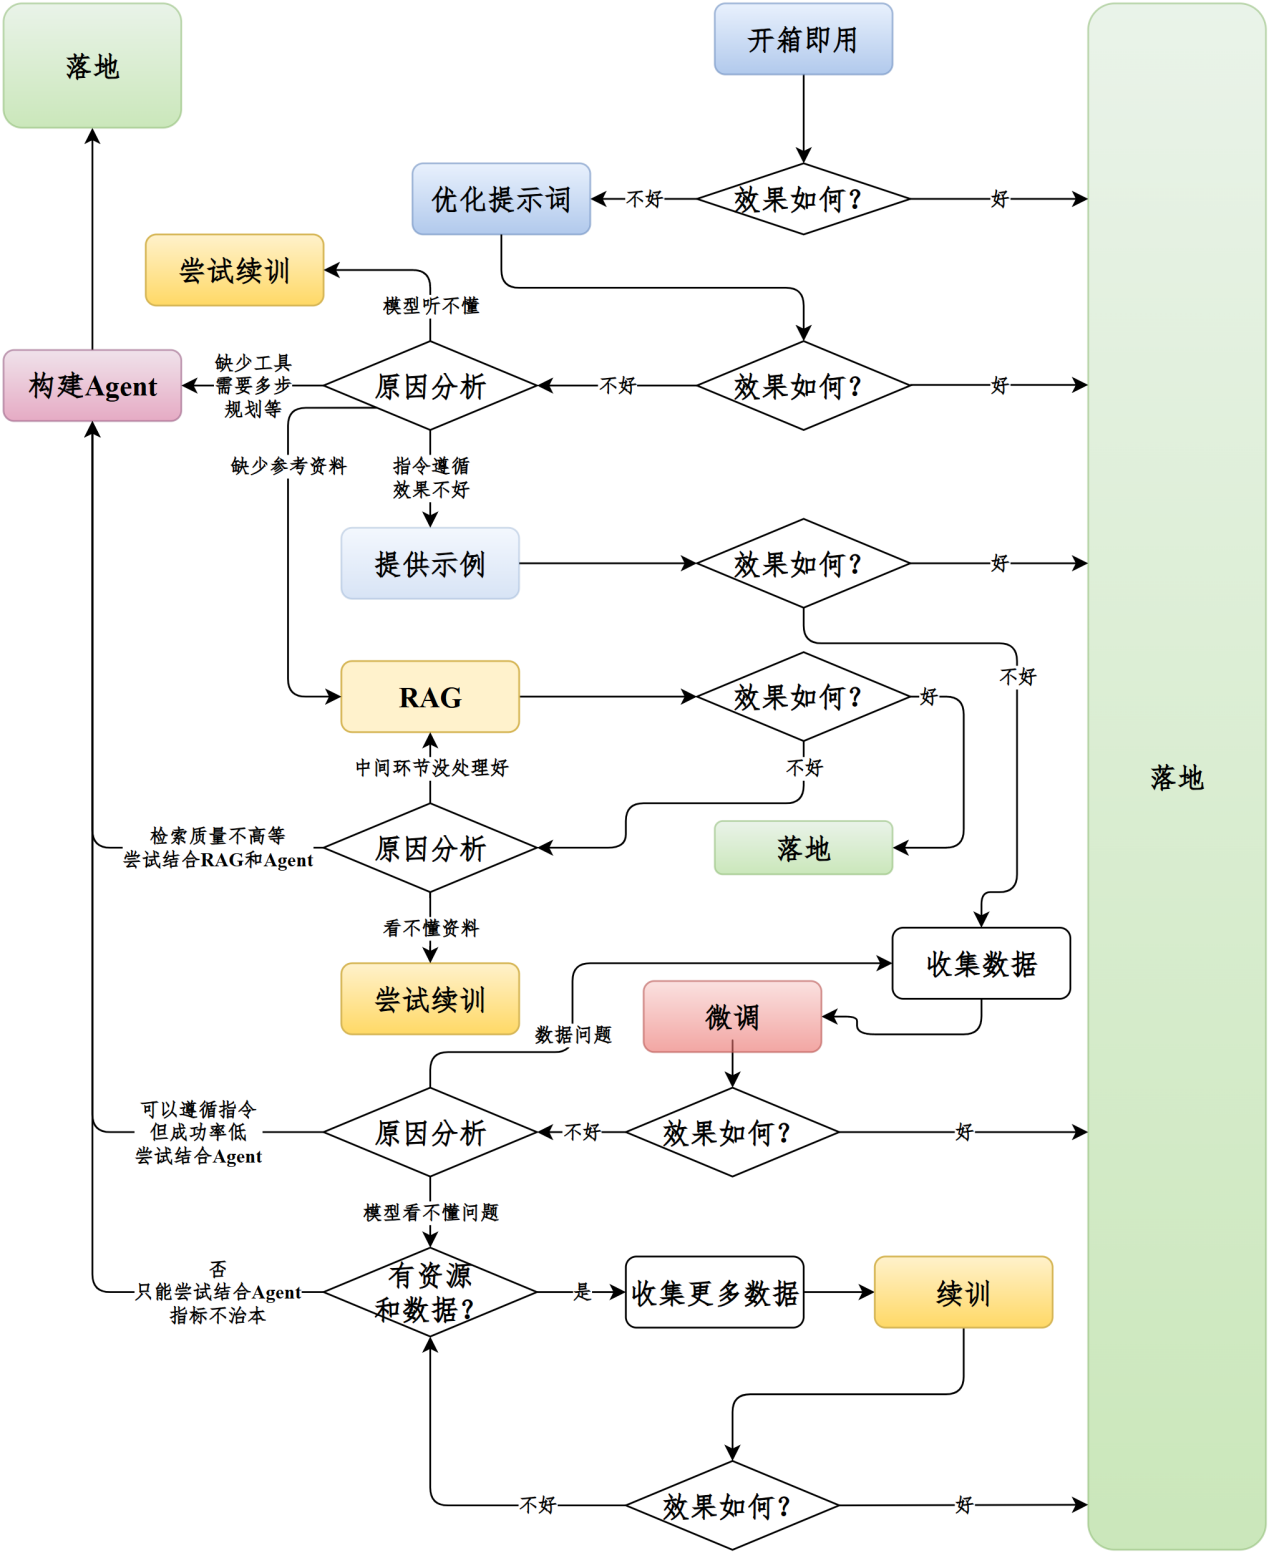
1、先做Prompt:如果只是需求表达不清楚,可以把输入、输出、约束写清楚,必要时在后面再做类型校验
2、做RAG:如果缺少的是企业的资料、文档依据或最新知识,优先建立知识库
3、再微调:如果长期行为不稳,并且有高质量的数据样本和评测标准,考虑微调
4、继续训练(慎重):当模型对特定领域里的知识很陌生时,考虑继续训练(但不如直接在网上找一个在对应领域的预训练模型来做)
5、流程固定先工作流:步骤明确、需要审计时,优先workflow
6、流程开放再Agent:步骤可能变化、需要动态调用工具和根据中间结果调整路线时,上Agent
整套流程并不是都需要做,对应能用轻量级的方案解决的,就不要引入重方案。
二、什么是RAG、模型微调以及智能体?
(1) RAG
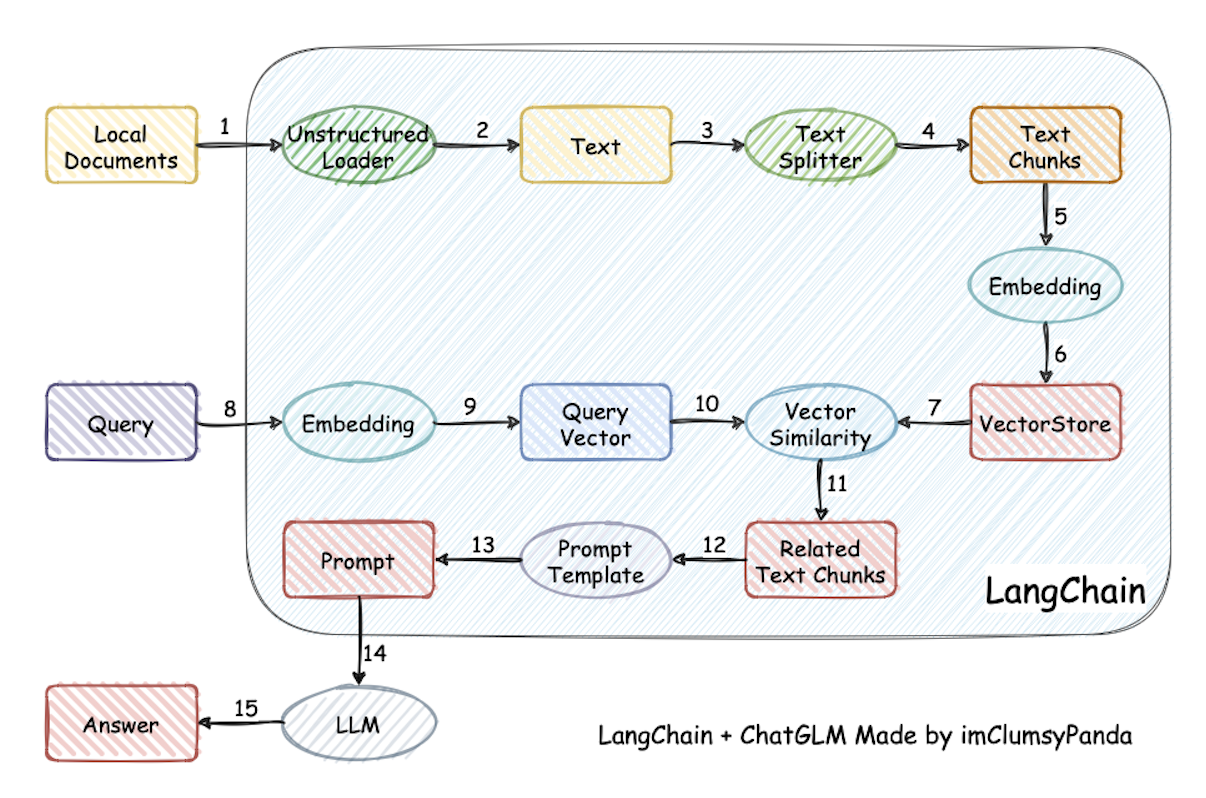
RAG 即 Retrieval-Augmented Generation,检索增强生成,是一种把信息检索与大模型生成结合起来的应用架构。它的基本流程并不复杂:用户提问 -》 系统从外部知识库里召回相关资料 -》 结合“问题 + 召回结果”一起发给大模型进行整理 -》 最后按特定格式进行输出生成答案,可以简记为 RAG = 先查找资料,再回答问题。其工作流程如下:
-
第一部分(知识库构建):
读取原始文档 -》 进行清洗和切分 -》 用嵌入emdedding模型把文本转为向量 -》 结合文本块、向量和元数据存入数据库,如chroma -
第二部分(检索与生成):
用户提问 -》 向量化问题 -》 知识库召回相关内容 -》 原问题和召回内容送入prompt -》 给到大模型生成答案并返回
1 | input("fsfs") |
其RAG的每一个环节(...)都会影响到最终效果,不只是 “向量 + 大模型” !!!
对于效果不理想的情况,需要进行拆解:
| 问题位置 | 典型表现 | 优先排查 |
|---|---|---|
| 文档质量 | 原文过期、冲突、缺页、扫描件 OCR 错误 | 更新资料、清洗文档、保留版本和来源 |
| 文档解析 | 表格、标题、层级、图片说明被解析乱 | 更换解析器,必要时引入人工校验 |
| 文本切分 | 检索片段太碎或太长,答案上下文不完整 | 调整 chunk size、overlap、按标题层级切分 |
| 召回策略 | 找不到正确片段,或者召回一堆无关内容 | 调整 Embedding、Top‑K、关键词检索、元数据过滤 |
| 重排序 | 正确片段被排到后面 | 引入 Reranker 或调整重排模型 |
| Prompt 增强 | 检索到了资料,但模型没按资料答 | 明确要求引用资料、缺依据时说明“不确定” |
| 生成模型 | 资料正确但推理仍错 | 更换模型、加强约束,必要时再看微调或继续训练 |
RAG的优势:
- 更新快:知识库更新后可以重新建索引,不必重新训练模型。
- 成本低:相比微调和续训,实施门槛和试错成本通常更低。
- 可追溯:检索结果可以保留来源、页码、文件名,方便核验。
因此RAG在典型的企业知识库问答、智能客服与售后助手(大华的华言)、研发文档问答(华昱欣的专利撰写助手)、运维排障助手、高考试题/合同/制度/政策/课程讲义等文档问答中比较实用
(2)微调 FT
微调(Fine-tuning)是指在已经训练好的基础模型上,继续用特定数据做训练,使模型在某类任务、某种风格或某种输出形式上表现更稳定。可以这么说微调主要是改变模型的“风格”,不会改变模型的“智商”,如 嬛嬛-chat,利用《甄嬛传》剧本中所有关于甄嬛的台词和语句,基于大模型进行LoRA微调得到的模仿甄嬛语气的聊天语言模型。
它最常见的用途包括:
-
让模型更稳定地遵循指令
-
让模型输出固定格式,例如 JSON、SQL、标签、分类结果
-
让模型更符合某种业务风格、品牌口吻或术语习惯
-
让模型在某类任务上更稳,例如分类、抽取、代码补全、客服回复
所以当出现模型行为不稳定、风格和话术需要长期同一、反复修改提示词/做结构化约束效果仍不理想,可进行微调处理,但同时也要考虑:数据量是否足够、评测标准是否合理、算力和预算是否可接受
目前微调方案分为以下几类(这里就不展开逐个介绍了):
-
(1)全参数微调(Full Fine-tuning):更新模型全部参数,理论上上限更高,但训练资源和显存开销都很大,适合资源充足、目标明确的场景。
-
(2)参数高效微调(PEFT, Parameter-Efficient Fine-Tuning):这类方法的核心思路是:尽量少改参数,用更低成本获得可接受的效果。 最常见的两种是:
- LoRA:冻结原模型大部分参数,只训练新增的低秩适配参数。
- QLoRA:在 LoRA 基础上结合低比特量化,进一步降低显存占用。
-
(3)其他高效方法:
- Adapter Tuning:在模型层间插入小型适配器模块
- Prefix Tuning:在输入前添加可学习的虚拟前缀
- P-Tuning v2:在模型每一层添加可训练的提示向量
(3)智能体Agent
在经典的AI语境中,智能体其实就是一个自己能够感知环境、拆解任务、调用工具、拿结果、再决定下一步改证明走的自主系统。你给他一个目标,他自己想办法搞定,不用一步步都盯着。在应用开发里边有更工程化的定义:智能体 = 大模型 + 工具 + 状态 + 执行流程,它的五大核心要素为:大语言模型、记忆系统、工具调用、规划决策、行动执行,如下图:
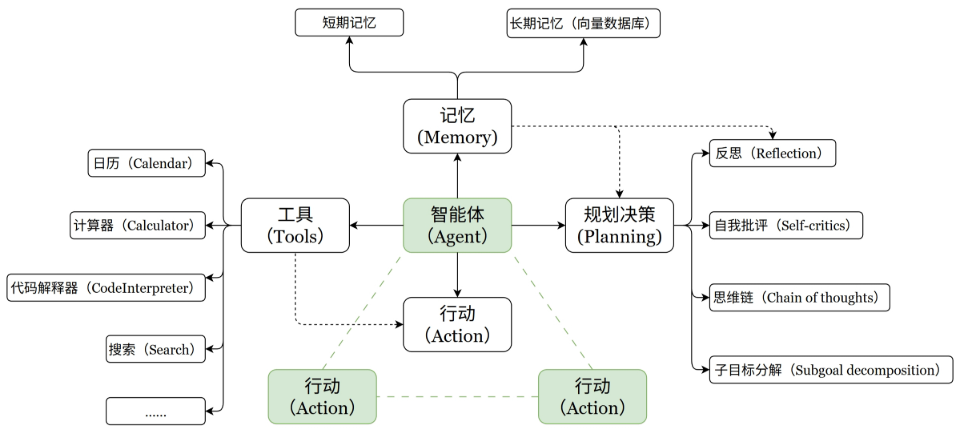
它与单纯的调用大模型的区别为:
- 直接调用大模型API就是“一问一答”,发一段 Prompt 过去,模型吐一段文本就回来了,直接完事,不会调整中间结果的策略。
- Agent有循环执行能力,可以反复走“思考-行动-反馈”,直到任务做完,同时它也能调用外部工具,搜索引擎、数据库等获取当前的最新信息,还具备记忆能力,能够根据之前的历史问题来引导后续的模型决策。
因此如果遇到的问题是 多任务;需要调用外部工具(天气等)、数据库、浏览器;中间结果会影响后续动作,流程不固定;需要状态管理和失败重试、反思机制等,就需要上考虑智能体了。